De flesta guider jag har stött på om att köra lokal AI utgår från att man ofta pratar engelska med sin AI. Så man väljer den största modellen som får plats på sitt grafikkort, stämmer av mot en topplista och sen borde det egentligen vara klart. Jag försökte köra en familjeassistent på svenska på ett grafikkort med 16 GB, och topplistan slutade vara hjälpsam efter ungefär tio minuter.
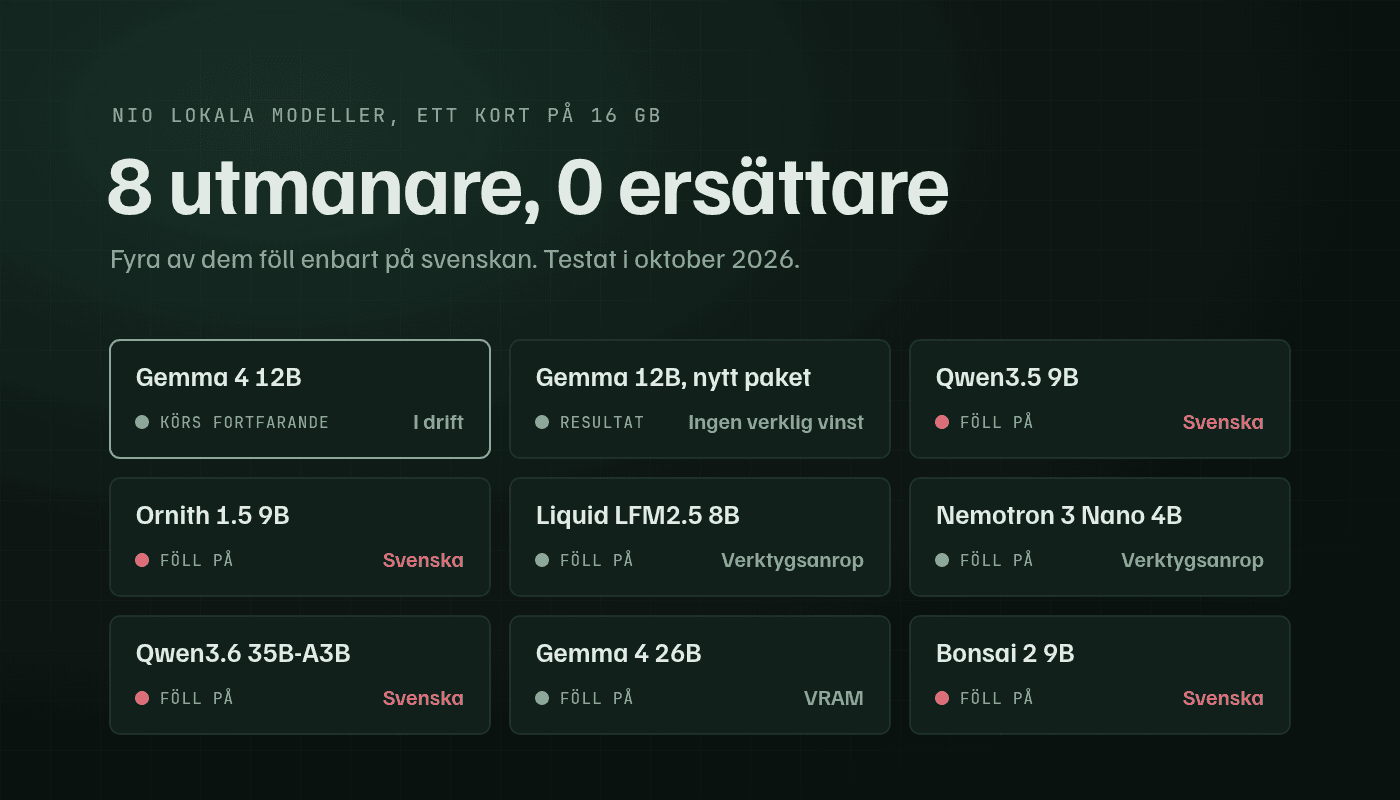
I oktober körde jag därför nio lokala modeller genom samma tester på samma kort. Åtta av dem utmanade modellen vi redan kör, Gemma 4 12B. Tyvärr kunde ingen av dem ersätta den. Fyra föll enbart på svenskan. Så vad visade testerna, och vad krävs för att driva ett svenskt hushåll med lokal AI?
Freya, och varför hon måste prata svenska
Freya är vår familjeassistent. Klockan sju varje morgon skickar hon information om den aktuella dagen: kalenderhändelser, en varning om en aktivitet saknar ansvarig förälder, dagens citat och barnens skollunch, så att vi inte lagar samma sak till middag samma dag. Ett andra meddelande är bara till mig, AI-nyheterna som är värda en titt baserat på mina personliga preferenser från olika plattformar. Under dagen skickar hon påminnelser: packa gympapåsen kvällen innan den yngsta har idrott, medicinpåminnelser tidigt på morgonen. På senare tid håller hon också koll på barnens sysslor, diskmaskin, återvinning och tvätt, i ett rullande treveckorsschema, så att ingen kan påstå att de inte visste vems tur det var.
Att göra allt på engelska hade varit mycket enklare. Men när jag började med röststyrning kändes svenska som det enda naturliga sättet att introducera henne till familjen. Den första introduktionen gick inte heller speciellt smärtfritt. När Freya gick med i familjens WhatsApp-grupp fick jag så mycket mothugg att jag plockade bort henne och arbetade om formatet. Till exempel går de långa kalendermeddelandena nu bara till föräldrarna. En familjs förtroende är lättare att förlora än att vinna, och en assistent som pratar ett annat språk med dem börjar redan i underläge.
Språket slutade vara en smaksak när jag byggde matplaneraren. Att matcha recept mot vad vi faktiskt kallar maträtterna, och kunna bygga inköpslistor med de svenska namnen som återfinns på hyllan i affären, fungerar bara om modellen kan svensk mat och svenska ord. Det har inte varit utan utmaningar med format: 10 tomater är inte samma sak som 10 burkar tomater, och smörgåsgurka, även om den är på nedsatt pris, är inte den gurka vi vill ha i tzatzikin. Med varje iteration tar vi oss närmare en lösning som fungerar, och i längden sparar vi pengar på matinköpen varje måndag. Ungefär 1 000-2 000 kr i månaden.
Hur vi testade
Jag kunde inte förlita mig på de publika topplistorna för det här, av en enkel anledning: de mäter kodning och problemlösning, och mitt system gör inget av det lokalt. Det körs på min hårdvara, använder röst och anropar verktyg. Så det är det de här testerna mäter.
Varje fas hade samma upplägg:
- Direkta verktygsanrop: 24 testcase på engelska. Anropar modellen rätt verktyg med rätt argument, och slutar den när den ska?
- Riktiga Freya-turer: isolerade OpenClaw-sessioner med verktyg som inte gör något på riktigt. Lampor, påminnelser som flyttas, en veckoregel för båda föräldrarna, en tjänst som ligger nere. I de senare faserna hälften på svenska, hälften på engelska.
- Svensk prosa: korta vardagsfrågor, betygsatta blint av mig utan att veta vilken modell som skrev vad.
- Lång kontext: tre koder gömda i en prompt på 58 000 tokens.
- Färsk kontroll: Gemma 12B kördes igen i varje fas, så varje kandidat jämförs med samma modell samma dag.
Inget rörde den riktiga installationen i huset. Varje verktyg var en fake endpoint som bara registrerade vad modellen försökte göra.
Att blint sätta betyg blev den mest underhållande delen för mig. När man kör sina egna modeller är det lätt att fastna på B:et, miljarderna parametrar, och klämma in den största modell kortet rymmer. Med namnen dolda försvinner den siffran och bara svenskan finns kvar att bedöma. I sista omgången betygsatte jag fyra vardagssvar från tre modeller, med blandade bokstäver, och öppnade facit först när alla fyra var klara. Gemma 12B fick aldrig under 4 och landade i snitt på 4,25 av 5. Qwen3.5 9B landade på 3,25. Betygen jämför bara svar inom samma ark: samma Gemma-svar fick 4,875 när de låg bredvid Bonsais. Ornith 1.5 9B, modellen som just klarat varje svenskt verktygsanrop, kom sist på 2,5: mörkaka i ett pastarecept, ett thailändskt ord mitt i en mening och ett godnattips jag fortfarande inte kan tolka, säg allt du har på dig rakt ur dig på ett papper. Alla tre klarade det lätta lika bra, en artig vägran att släcka en lampa. Skillnaderna syntes först när ett svar behövde vara längre än två meningar.
Så vad gjorde modellerna för fel?
| Modell | Testad på | Starkast | Föll på |
|---|---|---|---|
| Gemma 4 12B (i drift) | SV + EN | Bäst svenska i varje test, verktygsanrop 23/24 | Tappar en avslutande punkt, påstod en gång att den dimmat en lampa utan att göra det |
| Gemma 12B, uppdaterat paket | SV | Samma svenska, snabbare turer | Ingen verklig påvisad vinst |
| Qwen3.5 9B | SV + EN | 8/8 turer på engelska | Svenska 3,25/5, svenska påminnelseargument avvisades |
| Ornith 1.5 9B | SV + EN | Bäst exakt text av alla | Hittade på svenska ord, blandade in kinesiska och persiska |
| Liquid LFM2.5 8B | EN | Snabbast | Verktygsanrop 11/24, läste upp sitt resonemang |
| Nemotron 3 Nano 4B | EN | Liten och snabb | Verktygsanrop 13/24, tomma svar |
| Qwen3.6 35B-A3B | EN | Bäst resonemang och kod | ~1 GB VRAM kvar, trasig svenska |
| Gemma 4 26B | SV + EN | 16/16 turer, mycket snabbare | Fick inte plats bredvid vår mejlklassificerare |
| Bonsai 2 9B | SV + EN | Dubbla hastigheten, halva VRAM, 8/8 på engelska | 5/8 på svenska, blandade in norska och danska |
De påhittade svenska orden fick mig att skratta. Ljusbåten om en lampa. Påminnet, ett ord som inte finns. Grammatik är det lättaste att bedöma som människa, eftersom ett förvanskat ord på ens eget språk blir så uppenbart, och det är också det mest nedslående, eftersom man hade hoppats att man äntligen hittat en modell som fungerar. Tonalitet blev svårare. Vissa svar var riktigt charmiga, och jag kom på mig själv med att bli glad när en modell lade till ett litet "ska jag göra det?" på slutet.
Felen jag måste bry mig om är av ett annat slag. En modell som säger "klart" när den inte gjort något är en varningsflagga för mig, eftersom lamporna tänds och släcks varje dag. Om Freya tror att hon dimmat vardagsrummet när hon inte gjort det kommer någon att märka det, ta reda på varför och rätta till det. Den någon är jag. Klumpig svenska är den motsatta sortens fel: den förstör ingenting, men den säger att modellen passar dåligt till vardagens utmaningar, och det finns ingen inställning som fixar det. Av de två felen förlåter jag en misslyckad uppgift snabbare än en familj lär sig lita på en modell som stavar fel på enkla ord.
Den sista omgången var intressant. Jag trodde att engelska skulle göra verktygsanropen lättare för alla. Det gjorde det för Qwen3.5 (8/8 på engelska, 6/8 på svenska) och för Bonsai. Ornith klarade sig bättre på svenska. Gemma, vår baseline, fastnade i en tankeloop på engelska och upprepade "Wait, I'll do it. Actually, I'll use the tool." tills tiden tog slut. Den ärliga slutsatsen är alltså smalare än min utgångstes: verktygsanropen påverkas inte förutsägbart av språket. Prosan gör det. Det är den delen där bara Gemma gjorde rätt.
Vad det kostar att driva Freya
Elen är inte det som avgör vilken modell jag kommer använda. Men självklart mätte jag kortets förbrukning: att ha Gemma igång dygnet runt lägger till ungefär 1,4 W jämfört med ett vilande grafikkort, runt 1 kWh i månaden. Ett svenskt svar kostar 0,63 Wh. Tusen sådana är ungefär energin i en tvättmaskinskörning.
Priset är kortet och det kortet inte längre kan göra. Jag köpte RTX 5060 Ti 16 GB för 5 995 kr. I dag kostar samma kort 10 490 kr hos Webhallen. Det stänger dörren för det annars självklara nästa steget, ett andra kort för större modeller. Och ett GeForce RTX 5090 börjar på 62 000 kr. Jag var med när Voodoo Graphics kom 1996, och jag hade aldrig kunnat föreställa mig att ett kort gjort för gamers skulle kosta mer än en begagnad bil.
Gemma tar 8,5 GB av de 16. Bredvid sitter en mejlklassificerare på samma modell, och tidigare en rösttjänst som behövde nästan 4 GB på egen hand. Det fanns helt enkelt inte plats för Gemma, röst och mitt spontana spelande samtidigt, så spelandet flyttade till GeForce NOW för ungefär 120 kr i månaden, 1 440 kr om året. Kortet jag köpte motsvarar fyra år av GeForce NOW. Med dagens pris är det sju.
Det är här språket syns bland mina utgifter. På engelska hade jag kunnat gå mindre, inte större. Bonsai klarade varje engelsk uppgift på 5,1 GB med dubbel hastighet. En modell i den storleken lämnar plats för spel på samma kort. Så en del av det jag betalar GeForce NOW för är egentligen priset för att köra på svenska.
Råd till andra hushåll med andra språk än engelska
Om det är ett soloprojekt, bara för dig, kör på engelska. Du hittar troligen en modell som passar dina behov, och den blir antagligen mindre än du tror.
Om det är för en familj, börja med ditt modersmål som första test, före hastighet och storlek. Det gör varje senare idé lättare att bygga, och det är det enda sättet att få familjens godkännande.
Vad skulle få mig att byta från Gemma? En större modell med bättre nivå av reasoning som kommer närmare de frontier-modeller jag använder på jobbet, och som skriver svenska som min familj godkänner. Till dess får min modellbevakande agent inte kalla något för en kandidat utan publicerade svenska resultat för den exakta modellen.
Behåll det känsliga lokalt
Håll din känsliga data på en lokal modell. Mina mejl lämnar aldrig maskinen. Vardagschatt kan använda cloud-modellen som fallback, och det har jag vägt in med flit. Anledningen är att ingen vet vad data i molnet kommer att användas till i framtiden.